Cảnh báo frontend và bot phân loại sự cố có AI hỗ trợ
Cảnh báo dựa trên thay đổi tương đối của telemetry, cùng một chatbot có LLM hỗ trợ biến một cảnh báo thành nguyên nhân gốc có khả năng nhất, ngay trong luồng trao đổi nơi nhóm vẫn làm việc.
- Công nghệ
- SQL · Alerting service · LLM API · Kubernetes · Internal chat bot
Vấn đề
Những lượt bỏ dở lặng lẽ ở các điểm bàn giao cho bên thứ ba chỉ được phát hiện sau nhiều ngày qua bộ phận hỗ trợ khách hàng. Các cảnh báo dựa trên ngưỡng và quá ồn, nên mọi người đã quen với việc bỏ qua chúng.
Cách tiếp cận
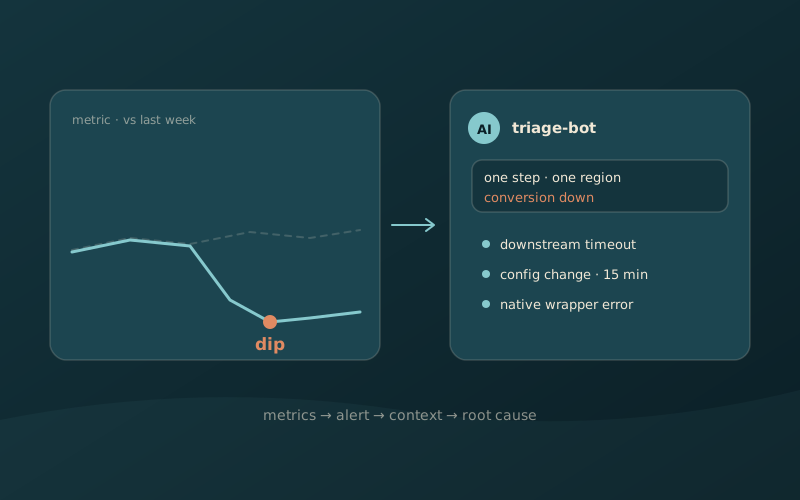
- Đường cơ sở tương đối, không phải ngưỡng cố định. Dịch vụ cảnh báo chạy SQL trên kho telemetry và so từng chỉ số với cùng giờ của tuần trước. Mức giảm 20% có ý nghĩa lúc 3 giờ sáng ở khu vực này cũng như buổi trưa ở khu vực khác, và các dao động lưu lượng toàn cầu không còn gây báo động giả.
- Cảnh báo đến cùng ngữ cảnh. Khi cảnh báo kích hoạt, một thẻ sự cố được đăng lên kênh chat của nhóm. Sau đó một worker nền thu thập các lỗi frontend gần đây, phiên bản cấu hình đang hoạt động và log triển khai, rồi gửi chúng dưới dạng prompt có cấu trúc tới LLM API.
- Bản tóm tắt ngay trong luồng. Bot trả lời bằng nguyên nhân gốc có khả năng nhất, chẳng hạn: tỷ lệ chuyển đổi của một bước giảm ở một khu vực, có lỗi null-pointer trong wrapper native, một thay đổi cấu hình được phát hành 15 phút trước và một dịch vụ phía sau đang hết thời gian chờ.
Kết quả
Thời gian phát hiện giảm từ vài giờ hoặc vài ngày xuống vài phút, thời gian khắc phục rút ngắn, và các cảnh báo trở thành thứ mọi người tin tưởng. Tôi cũng theo dõi tỷ lệ tín hiệu trên nhiễu của cảnh báo (phần cảnh báo ứng với sự cố thật) và thời gian trung bình giữa các lần lỗi của các module frontend.
Vì sao làm theo cách này
Một cảnh báo thông thường chỉ cho biết có thứ gì đó hỏng. Thu thập dữ liệu tự động rồi tóm tắt giúp thu hẹp khoảng cách giữa một chỉ số và việc một người hiểu nó, mà đó là nơi phần lớn thời gian phản ứng bị mất đi.