Alertas de frontend e um bot de triagem assistido por IA
Alertas baseados em mudança relativa na telemetria, mais um bot de chat assistido por LLM que transforma um alerta em uma causa raiz provável, na thread onde a equipe já trabalha.
- Stack
- SQL · Alerting service · LLM API · Kubernetes · Internal chat bot
O problema
Abandonos silenciosos durante repasses a terceiros eram descobertos dias depois pelo atendimento ao cliente. Os alertas eram baseados em limites fixos e barulhentos, então as pessoas aprenderam a ignorá-los.
A abordagem
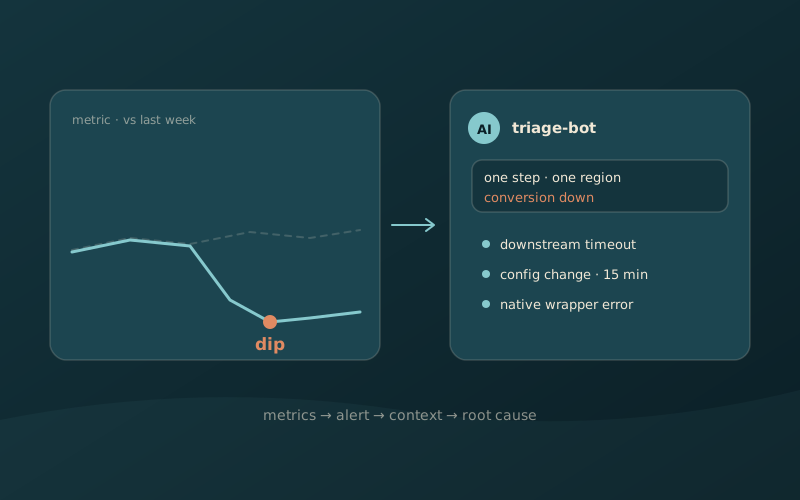
- Linhas de base relativas, não limites estáticos. O serviço de alertas executa SQL no armazenamento de telemetria e compara cada métrica com a mesma hora da semana passada. Uma queda de 20% significa algo às 3 da manhã em uma região e ao meio-dia em outra, e as oscilações do tráfego global deixam de causar alarmes falsos.
- Um alerta que chega com contexto. Quando um alerta dispara, ele publica um cartão de incidente no chat da equipe. Um worker em segundo plano então reúne erros recentes do frontend, a versão de configuração ativa e os logs de deploy, e os envia como um prompt estruturado a uma API de LLM.
- Um resumo na thread. O bot responde com uma causa raiz provável, por exemplo: a conversão de uma etapa caiu em uma região, há um erro de ponteiro nulo em um wrapper nativo, uma mudança de configuração saiu 15 minutos antes e um serviço downstream está estourando o tempo limite.
O resultado
O tempo de detecção caiu de horas ou dias para minutos, o tempo de mitigação diminuiu e os alertas passaram a ser alertas em que as pessoas confiam. Também acompanhei a relação sinal-ruído dos alertas (a parcela que corresponde a incidentes reais) e o tempo médio entre falhas dos módulos de frontend.
Por que assim
Um alerta comum diz que algo quebrou. Coletar os dados automaticamente e resumi-los fecha a lacuna entre uma métrica e uma pessoa que a entende, e era aí que ia a maior parte do tempo de resposta.