Алертинг для фронтенда и бот для разбора инцидентов с помощью ИИ
Алертинг по относительным изменениям телеметрии и чат-бот с поддержкой LLM, который превращает алерт в вероятную первопричину — прямо в треде, где команда уже работает.
- Стек
- SQL · Alerting service · LLM API · Kubernetes · Internal chat bot
Проблема
Тихие потери при передаче управления сторонним сервисам обнаруживались спустя дни через службу поддержки. Алерты опирались на пороги и были шумными, поэтому люди научились их игнорировать.
Подход
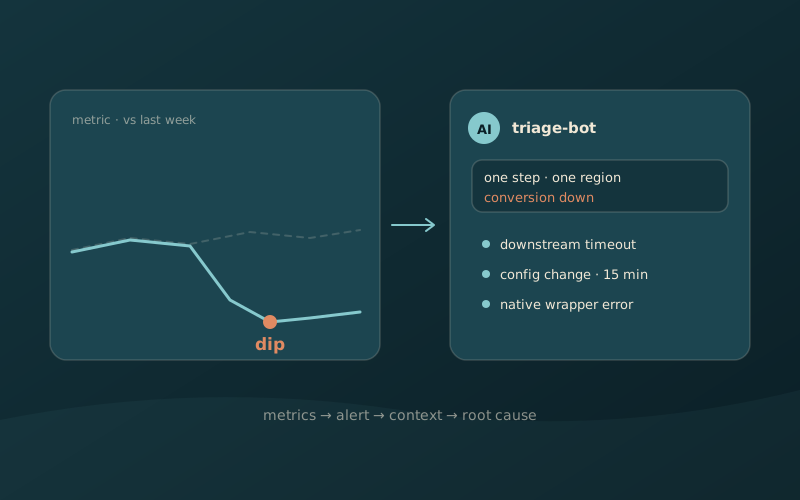
- Относительные базовые линии вместо статических порогов. Сервис алертинга выполняет SQL в хранилище телеметрии и сравнивает каждую метрику с тем же часом на прошлой неделе. Падение на 20 % значимо и в три часа ночи в одном регионе, и в полдень в другом, а колебания глобального трафика больше не вызывают ложных тревог.
- Алерт, который приходит с контекстом. Когда алерт срабатывает, в командный чат публикуется карточка инцидента. Фоновый воркер затем собирает свежие ошибки фронтенда, активную версию конфигурации и логи развёртывания и отправляет их структурированным промптом в API LLM.
- Сводка в треде. Бот отвечает вероятной первопричиной, например: конверсия одного шага упала в одном регионе, в нативной обёртке есть ошибка нулевого указателя, 15 минут назад вышло изменение конфигурации, а нижестоящий сервис выдаёт таймауты.
Результат
Время обнаружения сократилось с часов или дней до минут, время до смягчения последствий уменьшилось, а алерты стали такими, которым люди доверяют. Также отслеживались соотношение сигнал/шум алертов (доля, соответствующая реальным инцидентам) и среднее время между сбоями фронтенд-модулей.
Почему именно так
Обычный алерт говорит, что что-то сломалось. Автоматический сбор данных и их краткое изложение закрывают разрыв между метрикой и человеком, который её понимает, а именно там уходила большая часть времени реакции.