Alerting frontend et bot de tri assisté par IA
Un alerting sur les variations relatives de la télémétrie, plus un bot de discussion assisté par LLM qui transforme une alerte en cause racine probable, dans le fil où l’équipe travaille déjà.
- Stack
- SQL · Alerting service · LLM API · Kubernetes · Internal chat bot
Le problème
Les abandons silencieux lors de passages de relais vers des tiers étaient découverts des jours plus tard par le support client. Les alertes reposaient sur des seuils fixes et faisaient trop de bruit, si bien que l’on avait appris à les ignorer.
L’approche
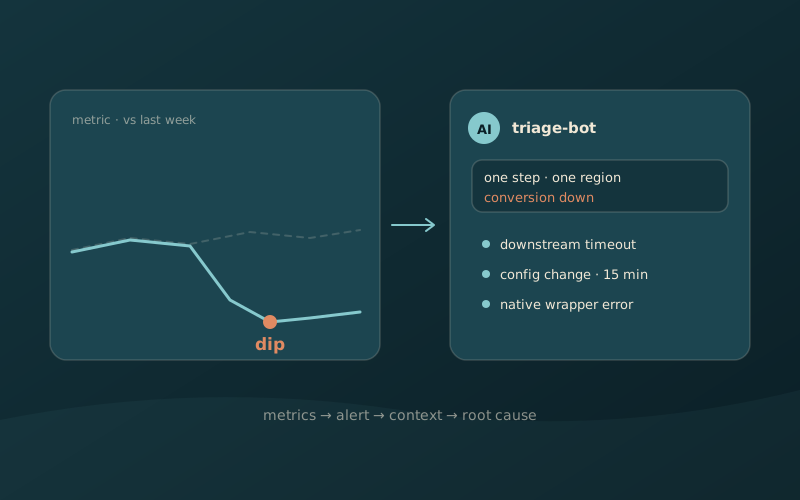
- Des références relatives, pas des seuils fixes. Le service d’alerting exécute du SQL sur le stockage de télémétrie et compare chaque métrique à la même heure de la semaine précédente. Une baisse de 20 % signifie quelque chose à 3 h du matin dans une région comme à midi dans une autre, et les variations du trafic mondial ne déclenchent plus de fausses alertes.
- Une alerte qui arrive avec son contexte. Quand une alerte se déclenche, une carte d’incident est publiée dans le chat de l’équipe. Un worker en arrière-plan rassemble alors les erreurs frontend récentes, la version de configuration active et les logs de déploiement, puis les envoie sous forme de prompt structuré à une API de LLM.
- Un résumé dans le fil. Le bot répond avec une cause racine probable, par exemple : la conversion d’une étape baisse dans une région, une erreur de pointeur nul se trouve dans un wrapper natif, un changement de configuration a été déployé 15 minutes plus tôt et un service en aval dépasse son délai.
Le résultat
Le délai de détection est passé de plusieurs heures ou jours à quelques minutes, le délai d’atténuation a diminué, et les alertes sont devenues des alertes auxquelles on fait confiance. J’ai aussi suivi le rapport signal/bruit des alertes (la part qui correspond à de vrais incidents) et le temps moyen entre pannes des modules frontend.
Pourquoi cette voie
Une alerte ordinaire dit que quelque chose est cassé. Collecter les données automatiquement et les résumer comble l’écart entre une métrique et une personne qui la comprend, et c’est là que passait l’essentiel du temps de réponse.