फ्रंटएंड अलर्टिंग और AI-सहायता वाला ट्रायेज बॉट
टेलीमेट्री पर सापेक्ष बदलाव पर आधारित अलर्टिंग, और LLM की मदद वाला चैट बॉट जो अलर्ट को संभावित मूल कारण में बदल देता है, उसी थ्रेड में जहाँ टीम पहले से काम करती है।
- टेक स्टैक
- SQL · Alerting service · LLM API · Kubernetes · Internal chat bot
समस्या
थर्ड-पार्टी को सौंपने के दौरान चुपचाप होने वाली गिरावट का पता कई दिन बाद कस्टमर सपोर्ट से चलता था। अलर्ट थ्रेशोल्ड-आधारित और शोर वाले थे, इसलिए लोग उन्हें अनदेखा करना सीख चुके थे।
तरीका
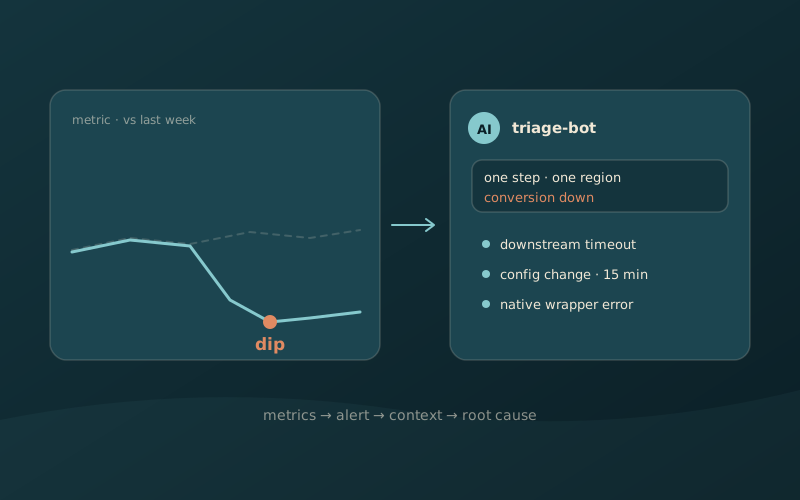
- सापेक्ष बेसलाइन, स्थिर थ्रेशोल्ड नहीं। अलर्टिंग सर्विस टेलीमेट्री स्टोर पर SQL चलाती है और हर मेट्रिक की तुलना पिछले हफ़्ते के उसी घंटे से करती है। 20% की गिरावट एक क्षेत्र में रात 3 बजे भी मायने रखती है और दूसरे में दोपहर को भी, और वैश्विक ट्रैफ़िक के उतार-चढ़ाव से झूठे अलार्म बंद हो जाते हैं।
- संदर्भ के साथ आने वाला अलर्ट। अलर्ट बजते ही टीम चैट में एक इंसिडेंट कार्ड पोस्ट होता है। फिर बैकग्राउंड वर्कर हाल की फ्रंटएंड त्रुटियाँ, सक्रिय कॉन्फ़िगरेशन वर्ज़न और डिप्लॉयमेंट लॉग इकट्ठा करता है, और उन्हें एक संरचित प्रॉम्प्ट के रूप में LLM API को भेजता है।
- थ्रेड में सारांश। बॉट एक संभावित मूल कारण के साथ जवाब देता है, जैसे: किसी एक क्षेत्र में एक चरण का कन्वर्ज़न गिरा, नेटिव रैपर में null-pointer त्रुटि है, 15 मिनट पहले एक कॉन्फ़िगरेशन बदलाव रिलीज़ हुआ और एक डाउनस्ट्रीम सर्विस टाइमआउट हो रही है।
नतीजा
पता लगाने का समय घंटों या दिनों से घटकर मिनटों में आ गया, निवारण का समय घटा, और अलर्ट ऐसे बन गए जिन पर लोग भरोसा करते हैं। मैंने अलर्ट का सिग्नल-टू-नॉइज़ (असली घटनाओं से मेल खाने वाले अलर्ट का हिस्सा) और फ्रंटएंड मॉड्यूल के लिए विफलताओं के बीच का औसत समय भी ट्रैक किया।
इस तरह क्यों
सामान्य अलर्ट बस बताता है कि कुछ टूटा है। डेटा अपने-आप इकट्ठा करके उसका सारांश देना मेट्रिक और किसी इंसान के उसे समझने के बीच की दूरी को पाटता है, और प्रतिक्रिया का ज़्यादातर समय वहीं जा रहा था।