Oncall Bot และการเฝ้าระวังฟรอนต์เอนด์
การแจ้งเตือนจากการเปลี่ยนแปลงแบบสัมพัทธ์บนข้อมูลเทเลเมทรีใน ClickHouse ร่วมกับแชตบอตที่ใช้ LLM ช่วย เปลี่ยนการแจ้งเตือนให้เป็นสาเหตุที่น่าจะเป็น ภายในเธรดที่ทีมใช้ทำงานอยู่แล้ว
- บทบาท
- Senior Frontend Engineer
- ช่วงเวลา
- 2025–ปัจจุบัน
- เทคโนโลยี
- ClickHouse · Alerting service · LLM API · Kubernetes · Internal chat bot
ปัญหา
ผู้ใช้ที่หลุดออกไปอย่างเงียบ ๆ ระหว่างส่งต่อให้บริการภายนอก เช่น การตรวจ NFC มักถูกพบหลายวันต่อมาผ่านฝ่ายบริการลูกค้า การแจ้งเตือนของเราใช้ค่าเกณฑ์ตายตัวและส่งเสียงรบกวนมาก จนทุกคนชินกับการเพิกเฉย
แนวทาง
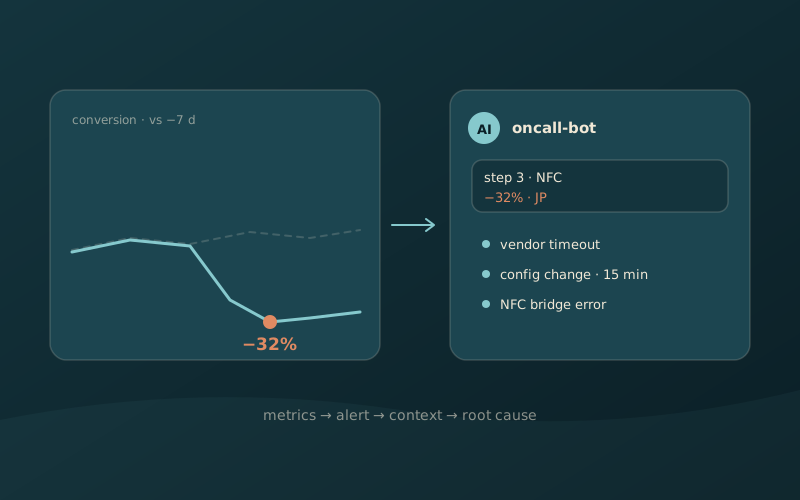
- ใช้ค่าฐานแบบสัมพัทธ์ ไม่ใช่เกณฑ์ตายตัว บริการแจ้งเตือนรัน SQL บน ClickHouse และเทียบแต่ละตัวชี้วัดกับชั่วโมงเดียวกันของสัปดาห์ก่อน อัตราคอนเวอร์ชันลดลง 20% มีความหมายต่างกันมากระหว่างตีสามที่โตเกียวกับเที่ยงวันที่เบอร์ลิน และการขึ้นลงของทราฟฟิกทั่วโลกก็ไม่ทำให้เกิดการแจ้งเตือนผิดอีก
- การแจ้งเตือนที่มาพร้อมบริบท เมื่อมีการแจ้งเตือน ระบบจะโพสต์การ์ดเหตุการณ์ลงในแพลตฟอร์มแชตภายใน จากนั้นงานเบื้องหลังจะรวบรวมสแต็กเทรซข้อผิดพลาดฝั่งฟรอนต์เอนด์ล่าสุดจาก ClickHouse เวอร์ชันคอนฟิกที่ใช้อยู่จากบริการคอนฟิก และล็อกการดีพลอยของ Kubernetes แล้วส่งเป็นพรอมต์แบบมีโครงสร้างไปยัง LLM API ระดับองค์กร
- สรุปไว้ในเธรด บอตตอบกลับด้วยสาเหตุที่น่าจะเป็น เช่น คอนเวอร์ชันขั้นที่ 3 ในญี่ปุ่นลดลง 32% มีข้อผิดพลาด null pointer ในตัวห่อสะพาน NFC มีการดีพลอยคอนฟิกเมื่อ 15 นาทีก่อน และเกตเวย์ของผู้ให้บริการหมดเวลาที่ฝั่งแบ็กเอนด์
ผลลัพธ์
เวลาที่ใช้ตรวจพบลดจากหลายชั่วโมงหรือหลายวันเหลือไม่ถึง 5 นาที เวลาที่ใช้บรรเทาปัญหาลดลง 65% และการแจ้งเตือนผิดพลาดลดลง 80% นอกจากนี้ยังติดตามอัตราสัญญาณต่อสัญญาณรบกวนของการแจ้งเตือน (สัดส่วนการแจ้งเตือนที่ตรงกับเหตุการณ์จริง) และระยะเวลาเฉลี่ยระหว่างความล้มเหลวของโมดูลฟรอนต์เอนด์ด้วย
ทำไมจึงทำแบบนี้
การแจ้งเตือนทั่วไปบอกแค่ว่ามีบางอย่างเสีย การรวบรวมข้อมูลและสรุปให้อัตโนมัติช่วยปิดช่องว่างระหว่างตัวชี้วัดกับการที่คนคนหนึ่งเข้าใจมัน และนั่นคือจุดที่เวลาในการรับมือส่วนใหญ่ถูกใช้ไป