Oncall Bot et monitoring frontend
Des alertes sur les variations relatives de la télémétrie ClickHouse, plus un chatbot assisté par LLM qui transforme une alerte en cause probable, dans le fil où l’équipe travaille déjà.
- Rôle
- Senior Frontend Engineer
- Période
- 2025–aujourd’hui
- Stack
- ClickHouse · Alerting service · LLM API · Kubernetes · Internal chat bot
Le problème
Les abandons silencieux lors des passages vers des tiers, comme les vérifications NFC, étaient découverts des jours plus tard par le support client. Nos alertes reposaient sur des seuils fixes et faisaient beaucoup de bruit, si bien que tout le monde avait appris à les ignorer.
L’approche
- Des références relatives plutôt que des seuils fixes. Le service d’alertes exécute du SQL sur ClickHouse et compare chaque métrique à la même heure de la semaine précédente. Une baisse de conversion de 20 % n’a pas le même sens à 3 heures du matin à Tokyo et à midi à Berlin, et les variations du trafic mondial ne déclenchent plus de fausses alertes.
- Une alerte qui arrive avec son contexte. Quand une alerte se déclenche, elle publie une fiche d’incident sur la plateforme de discussion interne. Un worker en arrière-plan rassemble ensuite les traces d’erreurs frontend récentes depuis ClickHouse, la version de configuration active depuis le service de configuration et les logs de déploiement Kubernetes, puis les envoie sous forme de prompt structuré à une API LLM d’entreprise.
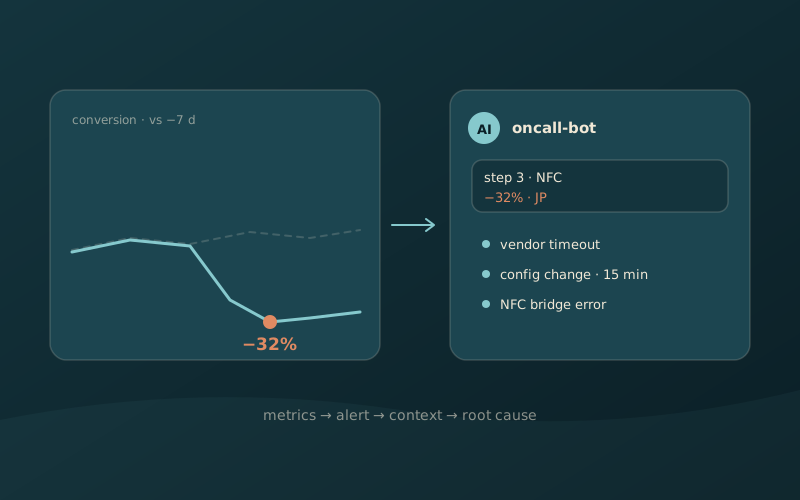
- Un résumé dans le fil. Le bot répond avec une cause probable, par exemple : conversion de l’étape 3 en baisse de 32 % au Japon, une erreur de pointeur nul dans l’enveloppe du pont NFC, un changement de configuration déployé 15 minutes plus tôt et une passerelle fournisseur qui expire côté backend.
Le résultat
Le délai de détection est passé de plusieurs heures ou jours à moins de 5 minutes, le délai d’atténuation a baissé de 65 % et les fausses alertes de 80 %. Le rapport signal sur bruit des alertes (la part des alertes liées à de vrais incidents) et le temps moyen entre pannes des modules frontend ont aussi été suivis.
Pourquoi ainsi
Une alerte classique dit seulement que quelque chose est cassé. Collecter les données automatiquement et les résumer comble l’écart entre une métrique et une personne qui la comprend, et c’est là que partait l’essentiel du temps de réponse.