Oncall Bot y monitorización del frontend
Alertas por cambio relativo sobre la telemetría de ClickHouse, más un chatbot asistido por LLM que convierte una alerta en una causa probable, en el mismo hilo donde ya trabaja el equipo.
- Rol
- Senior Frontend Engineer
- Periodo
- 2025–actualidad
- Stack
- ClickHouse · Alerting service · LLM API · Kubernetes · Internal chat bot
El problema
Los abandonos silenciosos al pasar a servicios de terceros, como las comprobaciones NFC, se descubrían días después a través de atención al cliente. Nuestras alertas se basaban en umbrales fijos y hacían mucho ruido, así que todo el mundo había aprendido a ignorarlas.
El enfoque
- Líneas base relativas, no umbrales fijos. El servicio de alertas ejecuta SQL sobre ClickHouse y compara cada métrica con la misma hora de la semana anterior. Una caída del 20 % en la conversión no significa lo mismo a las 3 de la madrugada en Tokio que al mediodía en Berlín, y las oscilaciones del tráfico mundial dejan de causar falsas alarmas.
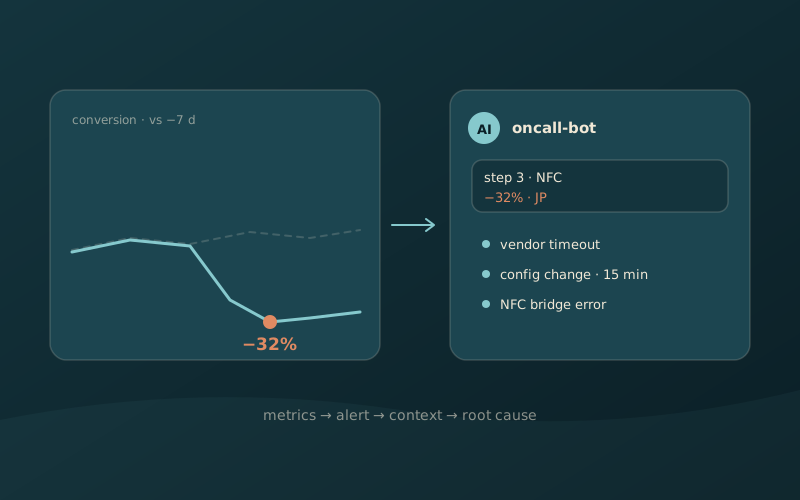
- Una alerta que llega con contexto. Cuando salta una alerta, publica una tarjeta de incidente en la plataforma de chat interna. Después, un proceso en segundo plano reúne las trazas recientes de errores del frontend desde ClickHouse, la versión de configuración activa desde el servicio de configuración y los registros de despliegue de Kubernetes, y los envía como un prompt estructurado a una API de LLM empresarial.
- Un resumen en el hilo. El bot responde con una causa probable, por ejemplo: la conversión del paso 3 bajó un 32 % en Japón, un error de puntero nulo en el envoltorio del puente NFC, un cambio de configuración desplegado 15 minutos antes y la pasarela de un proveedor agotando el tiempo en el backend.
El resultado
El tiempo de detección bajó de horas o días a menos de 5 minutos, el tiempo de mitigación se redujo un 65 % y las falsas alertas un 80 %. También se siguió la relación señal-ruido de las alertas (la proporción que corresponde a incidentes reales) y el tiempo medio entre fallos de los módulos del frontend.
Por qué así
Una alerta normal solo dice que algo se rompió. Reunir los datos automáticamente y resumirlos cierra la distancia entre una métrica y una persona que la entiende, y ahí se iba la mayor parte del tiempo de respuesta.