AIプラットフォーム
Oncall Bot とフロントエンド監視
ClickHouse のテレメトリに対する相対変化のアラートと、LLM を活用したチャットボット。チームが普段使うスレッドの中で、アラートを推定される根本原因に変えます。
- 役割
- Senior Frontend Engineer
- 期間
- 2025–現在
- 技術スタック
- ClickHouse · Alerting service · LLM API · Kubernetes · Internal chat bot
課題
NFC チェックなど外部サービスへの受け渡しの途中で起きる静かな離脱は、数日後にカスタマーサポート経由でようやく見つかっていました。アラートはしきい値ベースでノイズが多く、誰もが無視するのに慣れていました。
アプローチ
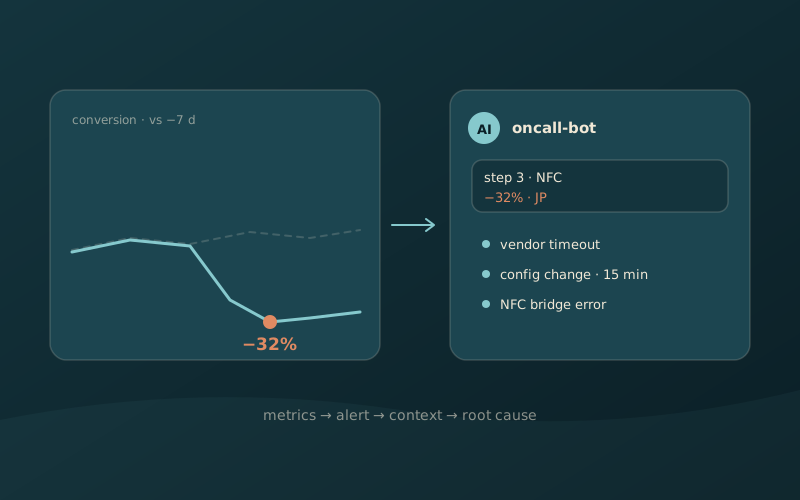
- 固定しきい値ではなく相対的なベースライン。 アラートサービスが ClickHouse に SQL を実行し、各指標を先週の同じ時間帯と比べます。コンバージョンが 20% 下がることの意味は、東京の午前 3 時とベルリンの正午ではまったく違います。これで世界のトラフィックの波による誤報がなくなりました。
- 文脈つきで届くアラート。 アラートが発火すると、社内チャットにインシデントカードを投稿します。続いてバックグラウンドのワーカーが、ClickHouse から最近のフロントエンドのエラースタックトレース、設定サービスから有効な設定バージョン、さらに Kubernetes のデプロイログを集め、構造化したプロンプトとして企業向け LLM API に送ります。
- スレッドの中に要約を。 ボットは推定される根本原因を返信します。たとえば「日本でステップ 3 のコンバージョンが 32% 低下、NFC ブリッジのラッパーで null 参照エラー、15 分前に設定変更をデプロイ、バックエンドでベンダーのゲートウェイがタイムアウト」といった内容です。
結果
検知までの時間は数時間〜数日から 5 分未満に、緩和までの時間は 65% 短縮、誤検知アラートは 80% 減りました。アラートのシグナル対ノイズ比(実際のインシデントにつながるアラートの割合)や、フロントエンドモジュールの平均故障間隔も追跡しました。
なぜこの方法なのか
普通のアラートは「何かが壊れた」と伝えるだけです。データを自動で集めて要約することで、指標と、それを人が理解するまでの間のギャップが埋まります。対応時間の大半が費やされていたのは、まさにそこでした。