PiattaformaWebMobile
Una piattaforma di telemetria frontend in tempo reale
Un SDK frontend tipizzato e una pipeline di eventi che hanno dato visibilità in tempo reale ai flussi utente a più passaggi, riducendo il rilevamento degli incidenti da giorni a minuti.
- Stack
- TypeScript · BFF · Event streaming · Columnar storage · Dashboards
Il problema
Alcuni utenti abbandonavano in silenzio un flusso lungo e a più passaggi. Quando si rompeva un’integrazione con una terza parte, nessuno se ne accorgeva: la diagnosi significava leggere a mano log del server frammentati e richiedeva giorni. Ognuno di quei giorni sono utenti reali che non hanno potuto completare.
L’approccio
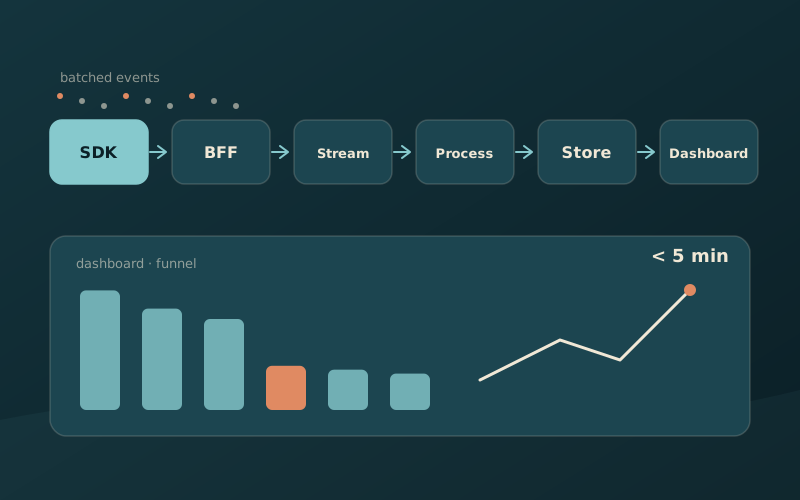
- Un SDK piccolo e tipizzato. Un unico tracker TypeScript raccoglieva gli stessi dati sulle azioni dell’utente su ogni schermata e piattaforma, così un evento significava la stessa cosa ovunque.
- Limitazione del ritmo con valvola di sicurezza. L’SDK raggruppa gli eventi e li invia dopo un breve timer o al raggiungimento di un limite di dimensione, a seconda di quale arriva prima. Una richiesta per clic fa esaurire i thread di rete del browser; trattenere gli eventi più a lungo rischia di perderli alla chiusura della scheda, quindi alla chiusura della pagina si usa
navigator.sendBeacon. - Un BFF che valida. I lotti arrivano a un Backend for Frontend che controlla lo schema rispetto alle definizioni TypeScript, verifica la plausibilità dei timestamp, rimuove i campi inattesi e i dati personali e aggiunge i metadati di sessione. Confrontare il verdetto del backend con ciò che mostrava l’interfaccia ha fatto emergere discordanze di stato tra i due.
- Una pipeline di streaming verso uno storage a colonne. Lo streaming assorbe i picchi di traffico, e lo storage a colonne risponde ad aggregazioni su insiemi di eventi molto grandi e ad alta cardinalità in millisecondi, dove gli storage a righe arrancano.
- Gestione silenziosa dei guasti. Se la pipeline è ferma, l’SDK conserva un piccolo buffer in locale e un circuit breaker passivo sospende l’invio. Non invia ping al server per verificarne lo stato; attende la prossima risposta riuscita.
Il risultato
Il tempo per rilevare un incidente è sceso da giorni a meno di 5 minuti. Quando un passaggio rotto significa molti tentativi falliti, è la differenza tra una nota in un postmortem e una correzione la stessa mattina.